maainstream.com — l'offre, formulée dans les termes du client.
Les programmes en ligne se vendent sur une promesse et se soldent sur un taux de complétion. Quelqu'un paie pour un challenge, une formation ou un mentorat, l'ouvre une fois, bute à 23 h sur la première chose qu'il ne comprend pas, et ne revient jamais. Personne n'est là. Le remboursement arrive trois semaines plus tard.
La réponse habituelle, c'est l'effectif : recruter du support, des community managers, des coachs. Ça marche, et ça cesse de marcher dès que le volume croît plus vite que la masse salariale. Maainstream est l'autre réponse — un coach IA qui vit à l'intérieur du programme, connaît le contenu, sait où chaque client en est réellement, et répond à 23 h.
Je l'ai construit de bout en bout : le produit, le système IA en dessous, et l'infrastructure qui le fait tourner. En solo, du premier commit en décembre 2025 jusqu'à une plateforme portant six chiffres de conversations en production.
Ce que c'est, concrètement#
Les clients ne parlent pas à un chatbot greffé sur un site vitrine. Ils se connectent à la plateforme où vit leur programme et parlent à un coach qui a le programme sous les yeux et leur propre historique derrière lui.
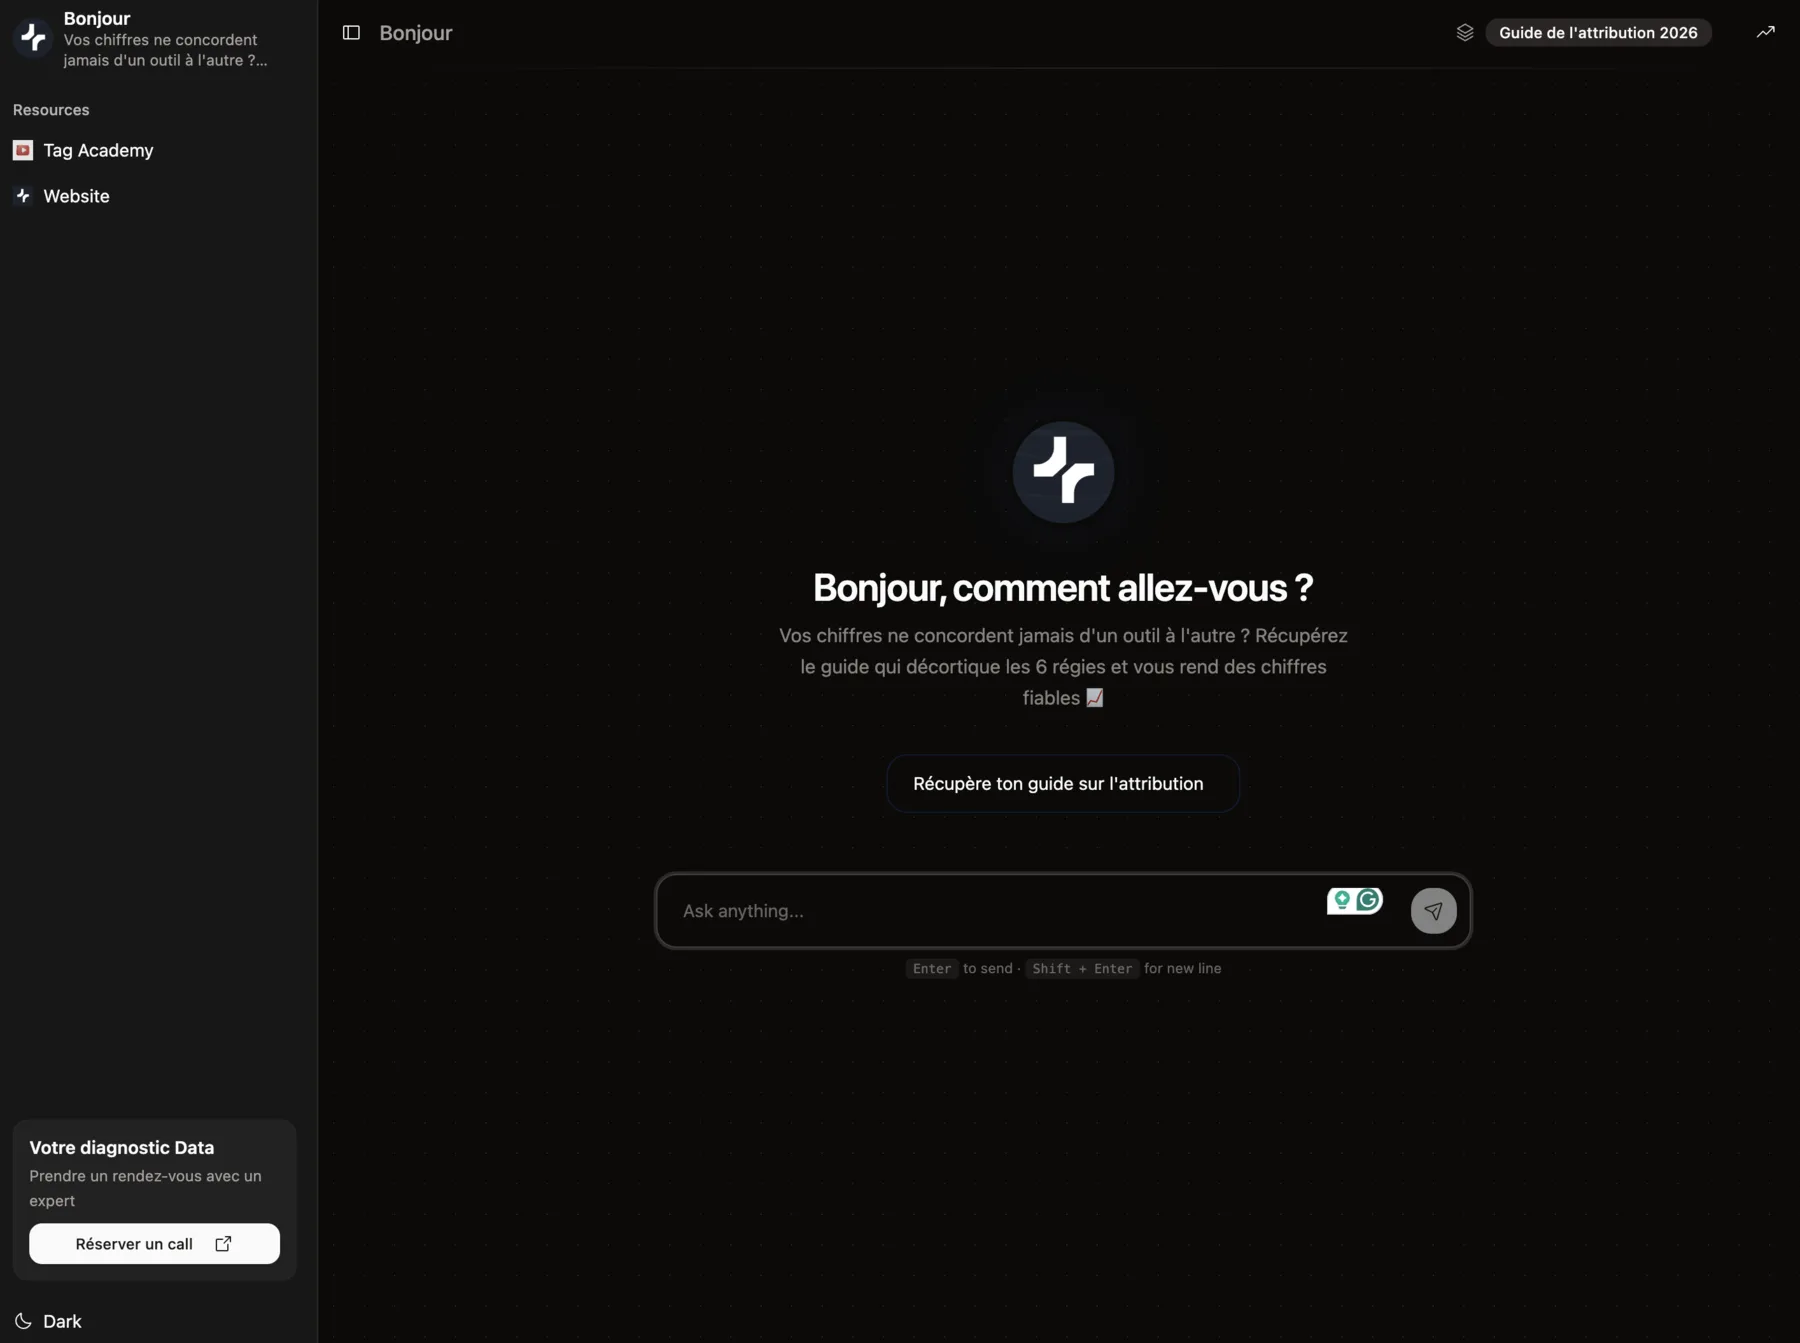
Le coach d'un client. Chaque instance est le même moteur, sous une autre marque, un autre contenu de programme, d'autres prompts d'amorce et d'autres appels à l'action.
Ce cadrage a fait l'essentiel du travail d'architecture. Un widget de support est générique et sans état : il répond à la question qu'on lui pose. Un coach n'est ni l'un ni l'autre. Il doit savoir que cette personne en est au jour 4 d'un challenge de 21 jours, qu'elle a sauté le module dont dépend sa question, et qu'elle a dit la semaine dernière qu'elle était sur le point d'abandonner. La conversation est un effet de bord de l'état, pas l'inverse.
Le système est également multi-tenant dès la première migration. Une organisation possède des agents ; un agent possède son persona, sa base de connaissances, ses étapes d'apprentissage, ses prompts suggérés et sa bannière latérale. Chaque client configure son propre coach sans qu'aucune partie n'en soit un fork. Un moteur, beaucoup de coachs.
Le backend est en Express et TypeScript sur PostgreSQL, avec Kysely plutôt qu'un ORM — les requêtes qui comptent ici sont des recherches vectorielles auxquelles viennent se greffer des filtres relationnels, et du SQL écrit à la main avec des types générés vaut mieux que de se battre contre un query builder qui cherche à masquer le SQL. Le frontend est en React 19 sur TanStack Router avec SSR, et le chat est streamé en SSE.
Le système IA#
Un agent, un petit jeu d'outils, une limite d'étapes stricte#
La couche conversationnelle n'est délibérément pas un essaim. C'est un agent unique, construit sur le Vercel AI SDK, avec deux outils — search_knowledge et save_lead_info — et stopWhen: stepCountIs(3).
Ce plafond d'étapes est le point important. Une boucle d'agent non bornée face à la fenêtre de chat d'un client payant, c'est une facture non bornée et un budget de latence non borné ; et en pratique, la troisième étape est le moment où le travail utile s'arrête et où les allers-retours commencent. Trois étapes suffisent pour chercher, lire et répondre.
La spécialisation vit ailleurs. Plutôt que d'aiguiller une conversation en direct entre des sous-agents, le système fait tourner un ensemble de tâches LLM étroites et mono-usage autour de la conversation — extraction de mémoire, résumé de conversation, évaluation de maîtrise, extraction de champs de lead. Chacune a un schéma, un prompt, et une définition du correct. Elles tournent sur une file, hors du chemin de réponse, là où un appel lent ou en échec ne fait attendre personne.
C'est l'arbitrage que je referais. L'aiguillage en cours de conversation ajoute un saut et un mode de défaillance à la seule interaction que le client vit réellement ; déplacer les spécialistes en arrière-plan garde le chemin direct court et rend chaque spécialiste testable indépendamment.
Une recherche cadrée sur l'endroit où l'apprenant en est vraiment#
Le coach n'est crédible que s'il répond à partir du contenu que le client a payé. Le programme de chaque client est ingéré, découpé, embarqué en vecteurs, et récupéré au moment de la réponse.
Le découpage suit les titres du markdown et conserve le titre attaché au fragment comme contexte, de sorte qu'un extrait sorti d'un long module transporte encore l'indication de la section dont il vient.
La recherche est un outil que l'agent choisit d'appeler, pas un pré-chargement aveugle agrafé à chaque tour. La plupart des messages d'une conversation de coaching — « ok merci », « j'essaie ce soir » — n'ont besoin d'aucune recherche, et payer un appel d'embedding plus une recherche vectorielle sur chacun d'eux est du pur gaspillage à six chiffres de conversations.
Plus important encore : la recherche est cadrée par étape. Elle est filtrée sur la partie du programme que l'apprenant a effectivement atteinte, de sorte que le coach ne puisse pas répondre à une question du jour 3 avec du contenu du jour 19 et gâcher la progression conçue par le client.
Ce filtre est la raison pour laquelle les vecteurs vivent dans PostgreSQL via pgvector plutôt que dans une base vectorielle dédiée. Les prédicats qui comptent — cette organisation, cet agent, cette étape, cette session — sont relationnels. Garder les embeddings dans la même base que cet état en fait une clause WHERE au lieu d'une jointure distribuée entre deux systèmes tenus ensemble par l'espoir.
La mémoire : recherche hybride, avec décroissance#
Tous les dix nouveaux messages, une tâche de fond résume la conversation et extrait ce que l'utilisateur a réellement déclaré sur lui-même, réparti en cinq catégories — préférence, fait, objectif, contexte, comportement — chacune assortie d'un score d'importance, sous un prompt dont la première instruction est de ne jamais spéculer. L'inférence est la façon dont un magasin de mémoire se remplit d'inepties assurées. Un balayage distinct rattrape les conversations qui s'arrêtent avant l'intervalle suivant et leur donne une dernière passe, pour que quelqu'un qui s'interrompt en cours de fil ne perde pas ce qu'il a dit.
La récupération de ces mémoires est hybride et non bloquante : une recherche cosinus pgvector et une recherche par mots-clés interrogent le même magasin, leurs résultats fusionnent, et les scores décroissent avec l'âge — une préférence exprimée il y a trois mois ne prime pas sur celle d'hier. Cinq mémoires au maximum atteignent le prompt système. Si la moitié vectorielle tombe, la moitié mots-clés répond quand même : un fournisseur d'embeddings qui passe un mauvais après-midi dégrade la mémoire au lieu de casser le chat.
La maîtrise : ce qui en fait un coach#
C'est ce qui sépare le produit d'un bot de support. Chaque étape d'un programme définit des sujets de maîtrise, et après chaque échange une tâche de fond évalue si l'apprenant a démontré sa compréhension de l'un d'eux.
Deux décisions de conception le portent :
L'évaluateur ne voit que les sujets plausiblement en jeu. Une passe d'embedding pré-filtre les sujets de l'étape par similarité avec l'échange récent, en gardant au plus cinq au-dessus du seuil. Envoyer quarante sujets à un LLM en lui demandant lesquels ont été démontrés produit une bouillie coûteuse ; lui en envoyer cinq produit un jugement.
Faire compte, pas seulement expliquer. Le prompt d'évaluation traite « j'ai créé mon compte » ou « ça n'a pas marché, je dois refaire » comme des preuves de compréhension, au même titre qu'une explication correcte. Dans un challenge, la démonstration de maîtrise est généralement une action rapportée en passant, pas une dissertation. La maîtrise est accordée sur un score de confiance pondéré entre historique et récence, contre un seuil que le client fixe par sujet.
Tout le chemin est dessiné par le coût : l'évaluation est entièrement sautée pour les messages de moins de vingt caractères, l'historique est plafonné à trois échanges, et les messages utilisateur sont tronqués. Rien de tout cela n'est visible pour le client, et tout cela fait la différence entre une fonctionnalité et une ligne de dépense.
Une passerelle, trois capacités, un repli inter-fournisseurs#
Chaque appel — chat, utilitaires, embeddings — passe par OpenRouter avec une seule clé par organisation. Un fournisseur à configurer, une facture à lire, et tout le catalogue de modèles disponible en direct pour permuter depuis l'interface d'administration.
Les capacités sont séparées, plutôt que de choisir un modèle une fois pour tout le système :
- chat — le tour que le client lit. Par défaut, Claude Sonnet.
- utilitaires — résumé, extraction de mémoire, évaluation de maîtrise, extraction de leads. Par défaut, un modèle de la classe Gemini Flash.
- embedding — figé à 1536 dimensions, parce que c'est la largeur des colonnes
vector(1536); en changer implique une migration qui ré-embarque tout.
Chaque capacité porte une chaîne de repli, et ces chaînes sont délibérément réparties entre fournisseurs différents, pour que la panne de l'un ne puisse pas faire tomber le chat. Sur une erreur de quota ou de limite de débit, l'agent réessaie en descendant la chaîne — mais uniquement si les en-têtes de réponse n'ont pas encore été envoyés, parce qu'il n'y a pas de façon honnête de redémarrer un flux qu'un client est déjà en train de lire. Un fournisseur en échec déclenche aussi une alerte sur l'organisation, pour que le client l'apprenne du produit plutôt que d'un de ses clients.
Tenir la ligne face à l'injection de prompt#
Un coach IA que l'on peut détourner de ses instructions est un risque porté par la marque de quelqu'un d'autre. Une couche de sécurité dédiée encadre le modèle des deux côtés :
- L'entrée est évaluée contre un catalogue de motifs d'injection — usurpation d'autorité (« transmis par Anthropic »), détournement de rôle, extraction du prompt système — avec des scores de risque qui pilotent l'autorisation, le signalement ou le blocage, les récidivistes voyant leur session marquée comme suspecte puis coupée.
- Le contenu récupéré est échappé avant d'atteindre le prompt. La base de connaissances est téléversée par le client, ce qui en fait une surface d'injection comme n'importe quelle autre entrée utilisateur.
- La sortie est validée contre les fuites de prompt système, la confusion de rôle et les fuites de balises structurelles avant d'atteindre le client, avec une réponse de repli en cas d'échec.
Le tout est couvert par des tests unitaires, ce qui est bien le moins pour la couche dont le mode de défaillance est une capture d'écran sur les réseaux.
La moitié ingrate#
L'ingestion, l'embedding, le traitement de la mémoire, le résumé et l'évaluation de maîtrise tournent comme des tâches BullMQ sur Redis, avec relances et backoff, et non dans les gestionnaires de requêtes. Le message d'un client ne doit pas attendre qu'un autre client téléverse son catalogue. La maîtrise et l'avancement d'étape sont poussés vers le navigateur en SSE via Redis pub/sub, pour qu'un apprenant voie un sujet se valider sans polling.
L'ensemble tourne sur Railway, avec Pino vers Loki et Prometheus vers Grafana derrière. L'histoire du déploiement est ennuyeuse à dessein, et elle devrait le rester longtemps.
Ce que voit l'opérateur#
Un produit IA que personne ne peut inspecter est un risque. La consommation de tokens et le coût exact facturé par OpenRouter sont enregistrés par appel, étiquetés par agent, conversation, session et utilisateur — c'est ce qui fait du tableau de bord de vrais chiffres plutôt que des estimations.
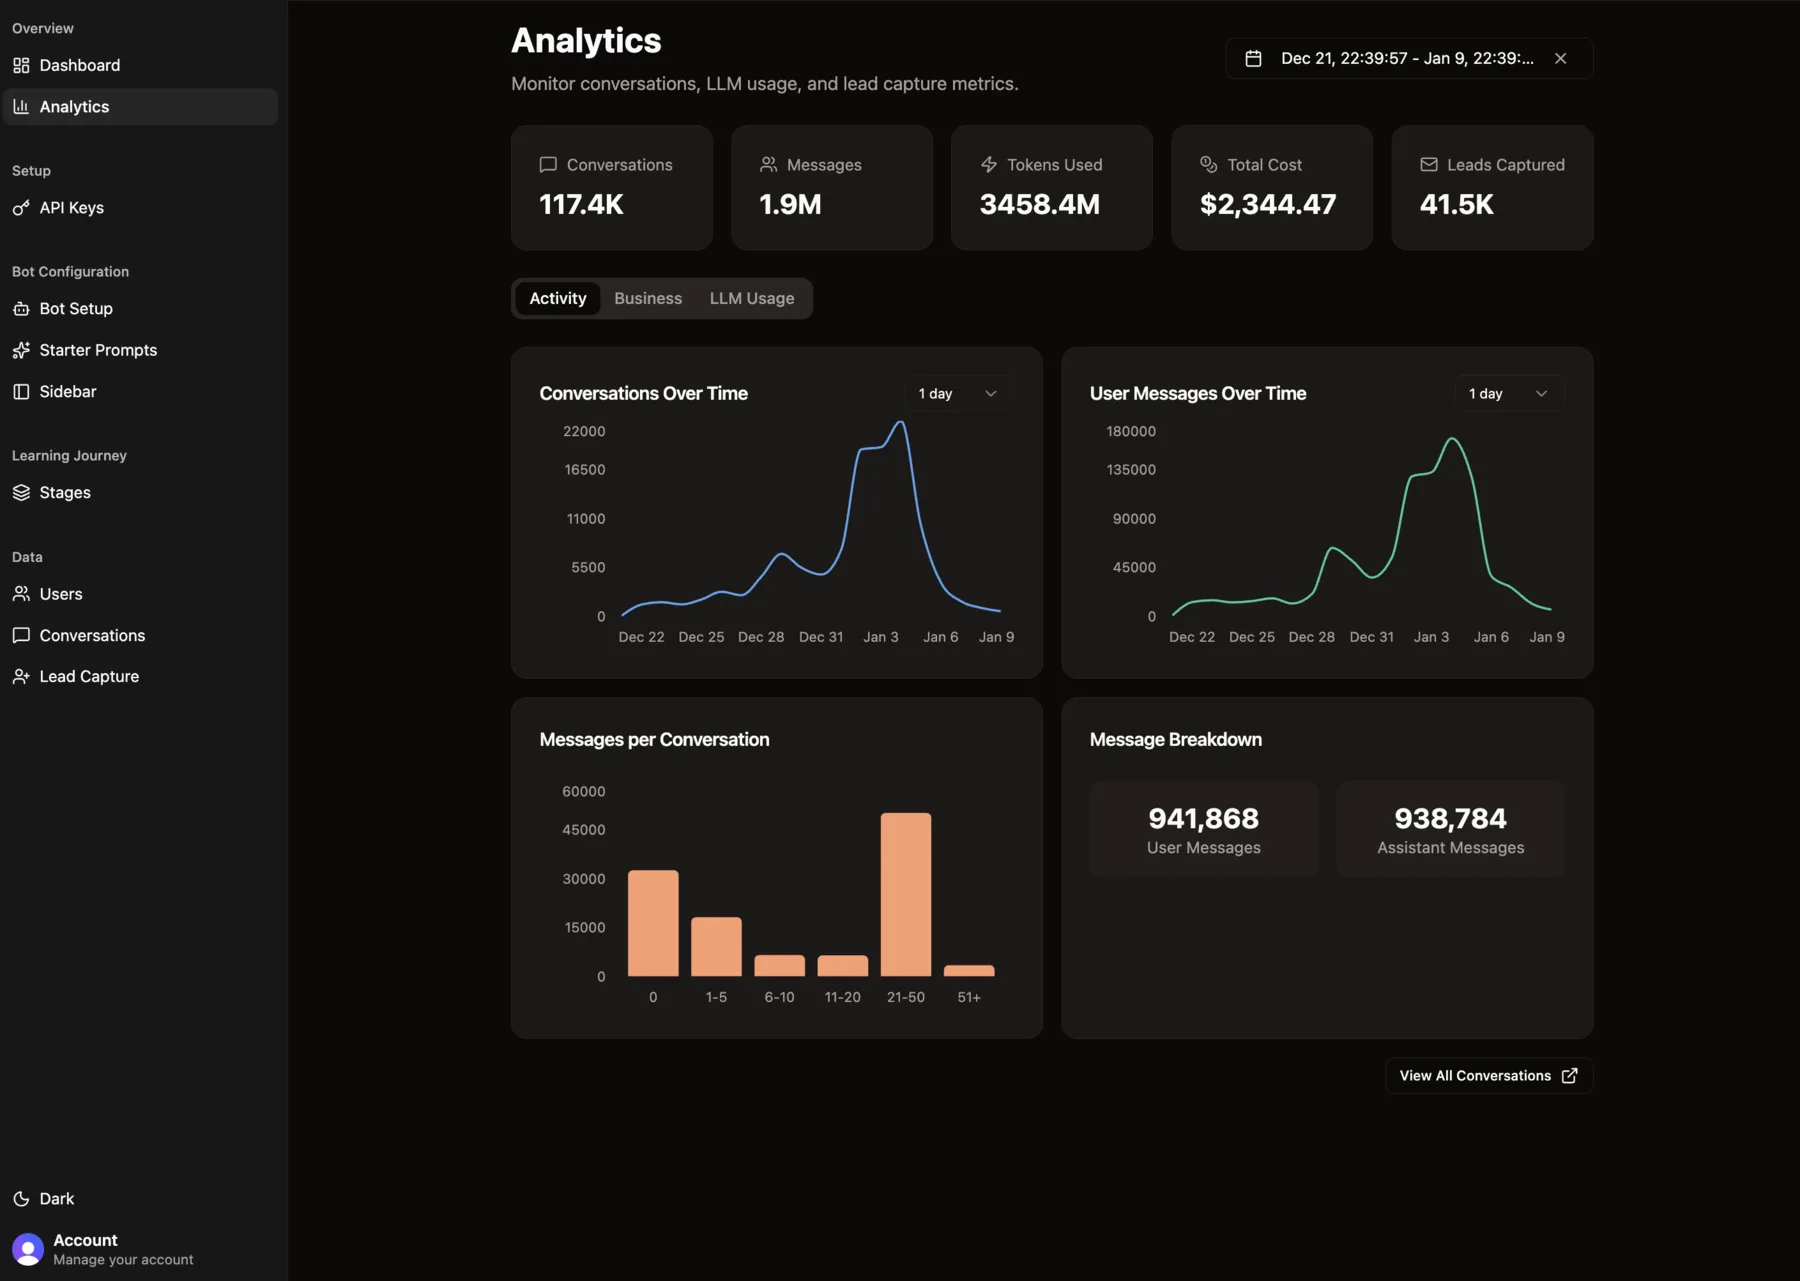
Volume de conversations, distribution des messages, dépense en tokens et capture de leads, par client et par période.
Deux choses y méritent leur place. Le nombre de messages par conversation est la distribution qui dit si le coach fonctionne : une barre à 0-1, c'est un produit avec lequel personne n'interagit, tandis qu'une masse assise dans la tranche 21-50 est la signature d'un client qui revient. Et la capture de leads est un objet de première classe plutôt qu'un transcript à exploiter plus tard : la moitié avant-vente du produit existe pour transformer un challenge terminé en conversation qualifiée, donc la qualification doit être une donnée structurée à l'instant où elle se produit.
Le flux de capture de leads est le seul endroit où le système écrit délibérément par-dessus le modèle : une fois le flux de l'agent terminé, s'il manque encore des champs obligatoires, un unique appel utilitaire extrait ce que le dernier message a révélé et rédige la question de relance, qui est ajoutée au flux que le client est déjà en train de lire. Un appel de plus, aucun aller-retour supplémentaire, et la question arrive attachée à une vraie réponse plutôt que sous forme d'interrogatoire.
Résultats#
Les chiffres ci-dessous sont ceux que la plateforme a mesurés en production, et ceux que le client publie publiquement :
- Plus de 100 000 conversations traitées à travers les programmes clients.
- 45-60 % de complétion de programme, contre les 5-20 % que ce marché considère comme normaux. Plus de clients atteignant la fin d'un challenge, c'est aussi plus de clients atteignant l'offre qui s'y trouve.
- Taux de remboursement divisé par trois. Les gens qui terminent ne réclament pas leur argent.
- L'équivalent de 2,4 postes de support à temps plein absorbé en 11 semaines chez un seul client, avec un ratio de 269 pour 1 entre messages positifs et négatifs.
- Sur un challenge à 14 M€, plus de 1 000 candidatures spontanées à un mentorat démarrant à 3 000 € — un effet aval du fait que davantage de personnes terminent d'abord la partie gratuite.
Le point d'ingénierie dans tout cela : aucun de ces chiffres ne vient d'un meilleur modèle. Ils viennent du fait que le coach sait à qui il parle, et du travail ingrat consistant à garder cette connaissance bon marché, cadrée et à jour.
Mon objectif : transformer votre besoin en un logiciel fiable, maintenable, et réellement exploitable en production.
Parlez-moi de votre projet par email